基于 Databend 的极简日志方案
· 阅读需 6 分钟
我早些年接触的日志量,每月也就 1 TB。后来每周 2 TB,一些电商业务每天就有 5 TB 以上。日志越收越多,运维查问题方便了,账单也越来越不好看。
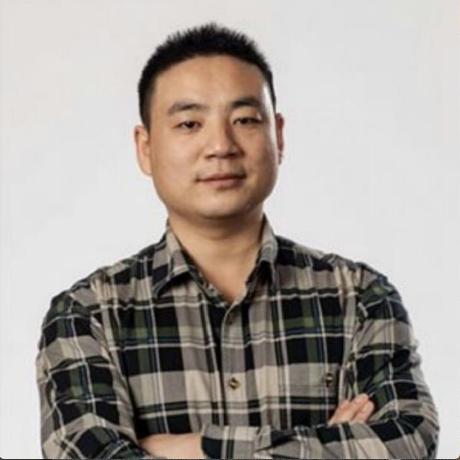
自己搭 Elasticsearch,要管集群;用云日志产品,省心一些,费用也得盯着。我在 2025 年 12 月分享过一套从生产环境整理出来的做法:用 Vector 收日志,S3 做中转,Databend Cloud 自动入库,后面直接用 SQL 查。
我早些年接触的日志量,每月也就 1 TB。后来每周 2 TB,一些电商业务每天就有 5 TB 以上。日志越收越多,运维查问题方便了,账单也越来越不好看。
自己搭 Elasticsearch,要管集群;用云日志产品,省心一些,费用也得盯着。我在 2025 年 12 月分享过一套从生产环境整理出来的做法:用 Vector 收日志,S3 做中转,Databend Cloud 自动入库,后面直接用 SQL 查。
我一直想知道,一个不会写 SQL 的业务人员,能不能靠 AI 把公司的订单数据分析清楚,交出一份领导愿意看的东西。光想没用,我自己试了一次。
数据用的是一份真实的公开订单数据:一家英国网店两年的全部交易,100 多万行。Evot 通过 Databend Cloud 的 Agent Skill 操作数据库。
前面的对话里,我们定好了导入到哪个库,Evot 也说明了写库只会新建一张表。在这个基础上,我说的是:
帮我把 https://archive.ics.uci.edu/dataset/502/online+retail+ii 数据加载到 Databend Cloud,建表导入数据,先完整跑一遍,看看能得出什么有价值的结论。
没有告诉它表结构,没有定义什么叫销售额、什么叫流失,也没有告诉它要分析哪些问题。从数据下载完到写出分析记录,它用了 7 分钟。这句话离开前面的对话就不够用了,想自己试的话,文末的“怎么复现”给了一段完整的指令。
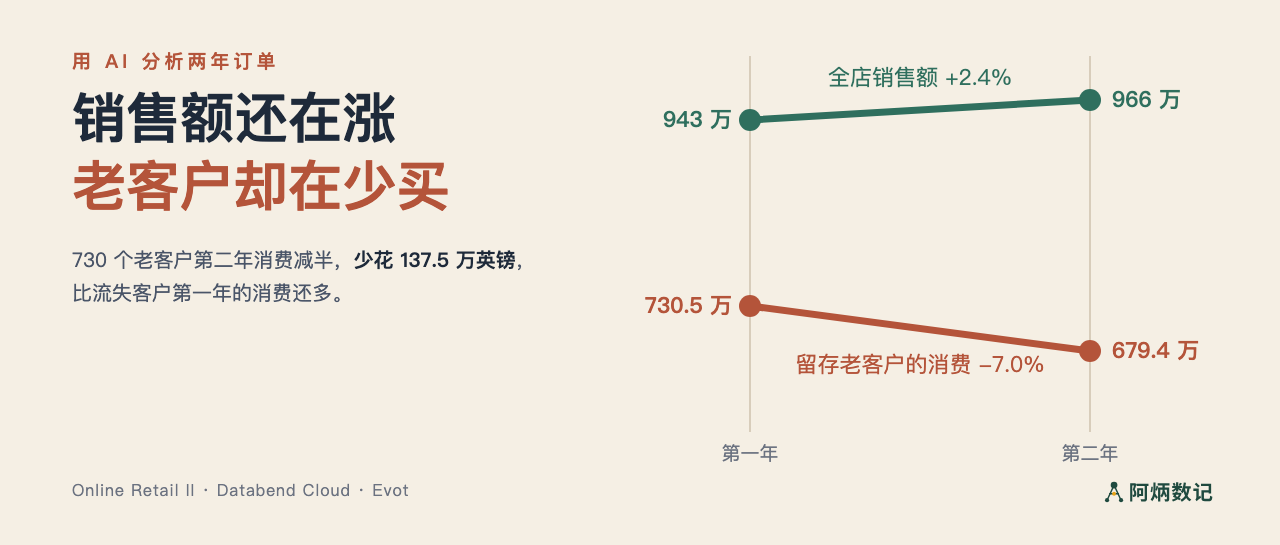
结果里最有用的一条:这家店两年销售额只涨了 2.4%,看上去很平稳;但有 730 个老客户第二年的消费减少了一半以上,少花的钱比所有流失客户第一年花的加起来还多。同时也让我看到一个店铺可能存在的生命周期。
下面按实际过程写:它做了什么,哪里出了错,最后交出了什么。文中的数字都能对应到保存下来的查询结果。
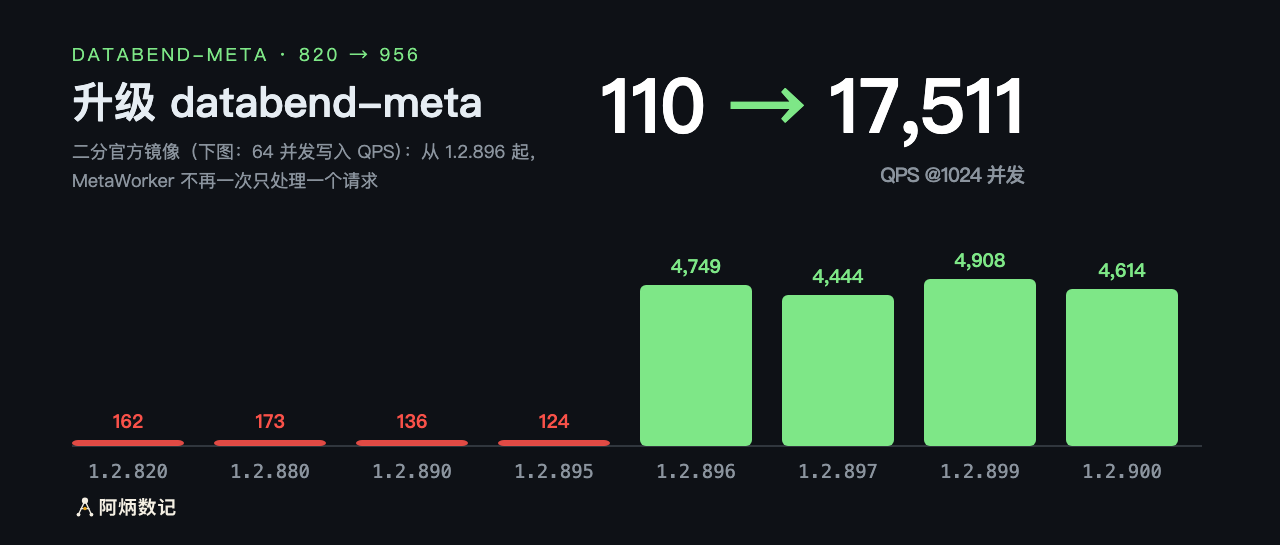
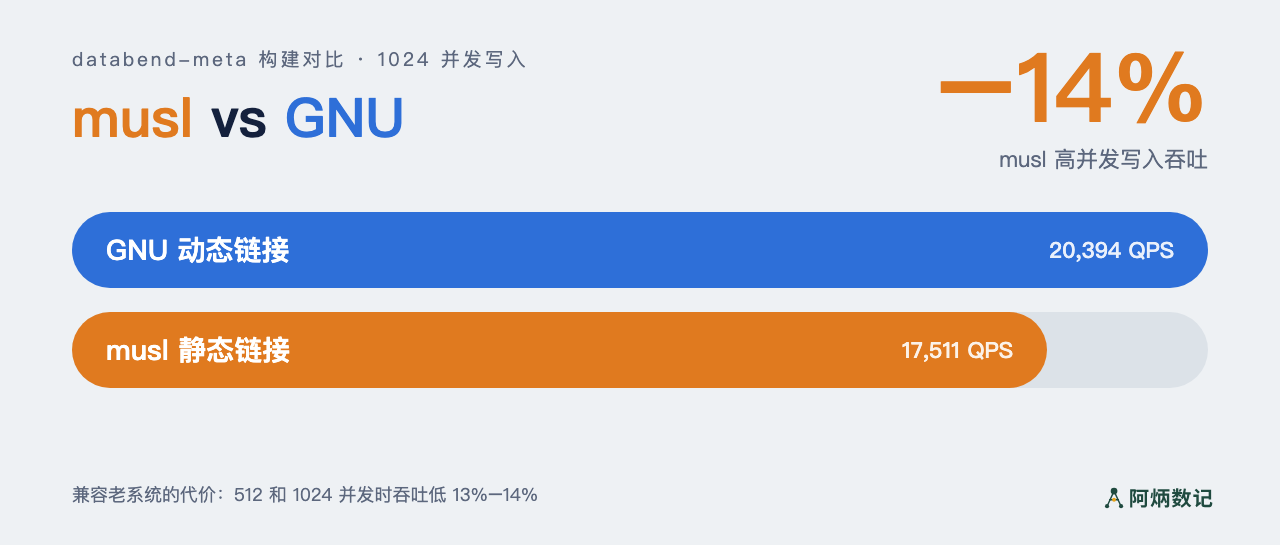
上一篇测 databend-meta 的 musl 和 GNU 构建时,我顺手把 1.2.820 也跑了一遍。820 是 2025 年 9 月的 nightly。跑出来的数字让我一度以为脚本写错了:并发从 16 加到 1536,写入吞吐一直在 110 QPS 左右,延迟跟着并发一起涨。同一台机器上,1.2.956 在 1024 并发时是 17,511 QPS。
脚本没问题。我用官方镜像在 820 和 956 之间做了二分,问题出在 1.2.896 之前 MetaWorker 里的一个循环:它一次只处理一个请求。
先说结论:写入并发高的环境,databend-meta 至少要升到 1.2.896,能用新版本就直接用新版本。按兼容性文档,query 还停在 820 的话,也可以先单独升级 meta。
Databend 推荐用容器镜像部署。信创环境常常是例外:不少系统版本偏老,glibc 版本不够,容器也不一定能用,通常只能部署静态链接的 musl 二进制。静态包不依赖系统的 glibc 版本,兼容性更好。
兼容性解决了,性能会不会受影响?musl 和 glibc 在系统调用封装、线程和锁等基础实现上有差异,databend-meta 又是一个处理大量小请求的 Raft 服务。我把同一份代码分别编译成 musl 静态版和 GNU 动态版,用同样的负载压测,量化一下兼容的代价。
结论:
一句话结论:在本次测试条件下,信创环境使用 musl 包,高并发写入可按吞吐低约 14% 来规划容量;能用容器,或系统 glibc 版本足够时,不必选择 musl。
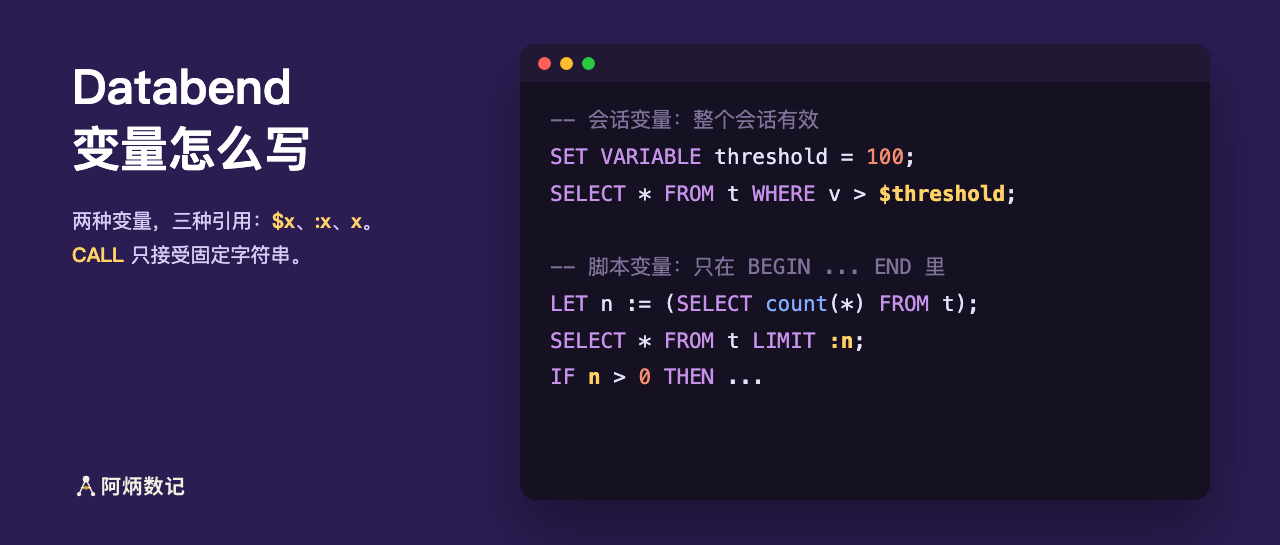
Databend 的变量分两种:会话变量和脚本变量。两者定义方式、作用范围、引用写法都不同,$name、:name、name 三种写法容易混用;CALL system$xxx(...) 对参数又有单独的限制。
先给结论:
SET VARIABLE 定义,$name 引用,在当前会话内有效。LET 定义,只在 BEGIN ... END 内有效。SQL 语句里写 :name,IF、RETURN 等脚本表达式里写 name。CALL system$xxx(...) 只接受固定字符串,传不了变量,需要改用 SELECT * FROM xxx(...)。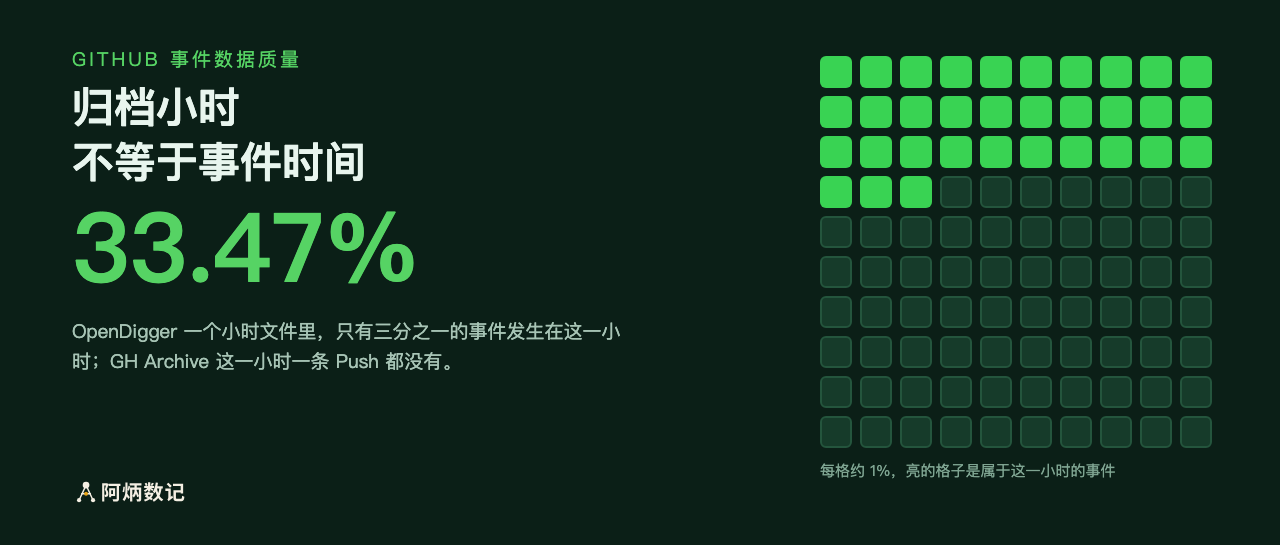
阿里云 MaxCompute 文档里有一个案例:用 GitHub 公共事件数据,给开源数据库做热度和活跃度排名。我想在 Databend Cloud 上用最新数据复现它。
这次我没有手写 SQL:AI Agent Evot 通过 Databend 官方的 databend-cloud skill 操作 Databend Cloud,我用自然语言提要求,建表、导入和检查的 SQL 都由 Evot 生成并执行。
动手前,我让 Evot 先导入一个小时试试:2026 年 10 月 24 日 0 点(UTC)。
GH Archive(按小时归档 GitHub 公共事件的公开数据集)的这个文件里,一条 Push 都没有。换成 OpenDigger 的同名文件,有 288,431 条 Push——但按记录里的 created_at,没有一条属于这个小时,全部是前一天的。
两份数据导入时都是零错误、零重复,问题出在数据本身。这一小时的样本里,有三个会直接影响排名的问题:
一句话结论:近期的 GitHub 事件数据适合观察趋势、发现线索,不适合直接做精确统计和排名。
范围说明:结论来自两个来源各一个完整小时文件,加上少量邻近小时和 API 抽查,不是全站长期审计。第 3 点有 GitHub 官方公告;前两点是实测现象,根因尚未完全确定。
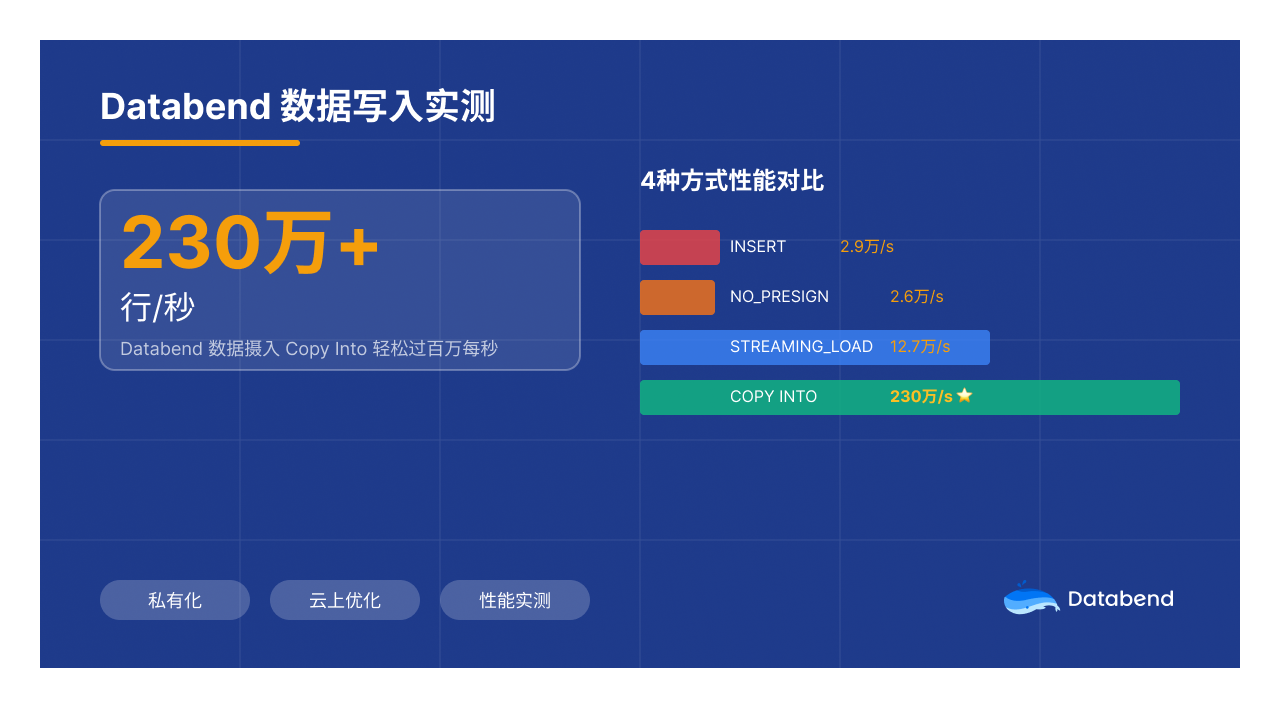 Databend 云原生湖仓同时支持私有化和公有云两种部署形态,因此在写入方式上也共提供了4方式种选择。本文一方面通过性能测试认识不同形态的性能差异,另一方面也尝试理解这些设计背后的原因,进而体会如何结合业务场景选择最适合的写入方式。
 在 AI 大火的背景下,数据库公司基本都在规划着如何与 AI 结合,也就有了这次活动。我想约一下同行朋友一起交流,看看 Data + AI 或是 AI + Data 这两个方向会碰撞出什么样的结果。本次活动邀请到:
数据归档: 随着生产数据库数据量增大,对于备份和性能都带来比较严重的影响,可以通过归档的方案,可以将主库中早期不使用的数据,如早期订单或日志移动到归档库中。减少生产数据库的数据大小,提升生产数据库的性能。 数据归档是生产数据中面临的一个重要工作,在本篇文章中使用 Databend Cloud 归档 OceanBase, 同理也适用于: MySQL, TiDB, PostgreSQL, Oracle, SQL Server 等。 使用工具: db-archiver 数据存储: 用户端的 bucket 中 计算资源: Databend Cloud 按需付费
随着大数据收集和存储技术的解决,公司和企业的数据量也在不断增加,但只有将更多数据组合起来,才能产生更大的价值。本篇文章结合 Databend 在某省级大数据交易所落地后的经验,探讨对数据交易的理解及可信数据空间做一些展望。。