基于 Databend 的极简日志方案
我早些年接触的日志量,每月也就 1 TB。后来每周 2 TB,一些电商业务每天就有 5 TB 以上。日志越收越多,运维查问题方便了,账单也越来越不好看。
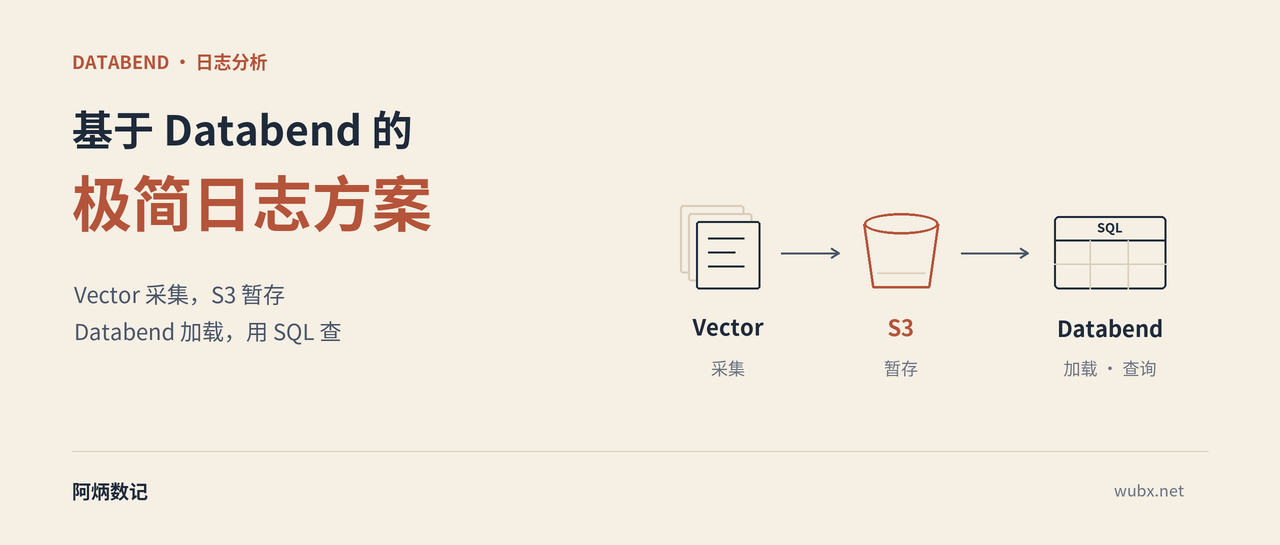
自己搭 Elasticsearch,要管集群;用云日志产品,省心一些,费用也得盯着。我在 2025 年 12 月分享过一套从生产环境整理出来的做法:用 Vector 收日志,S3 做中转,Databend Cloud 自动入库,后面直接用 SQL 查。
采集和入库
拿 Nginx 网关日志来说,每台网关上放一个 Vector。它把日志里的 IP、时间、URL、状态码、请求耗时解析出来,转成 NDJSON,攒一批后用 gzip 压缩,上传到 S3。
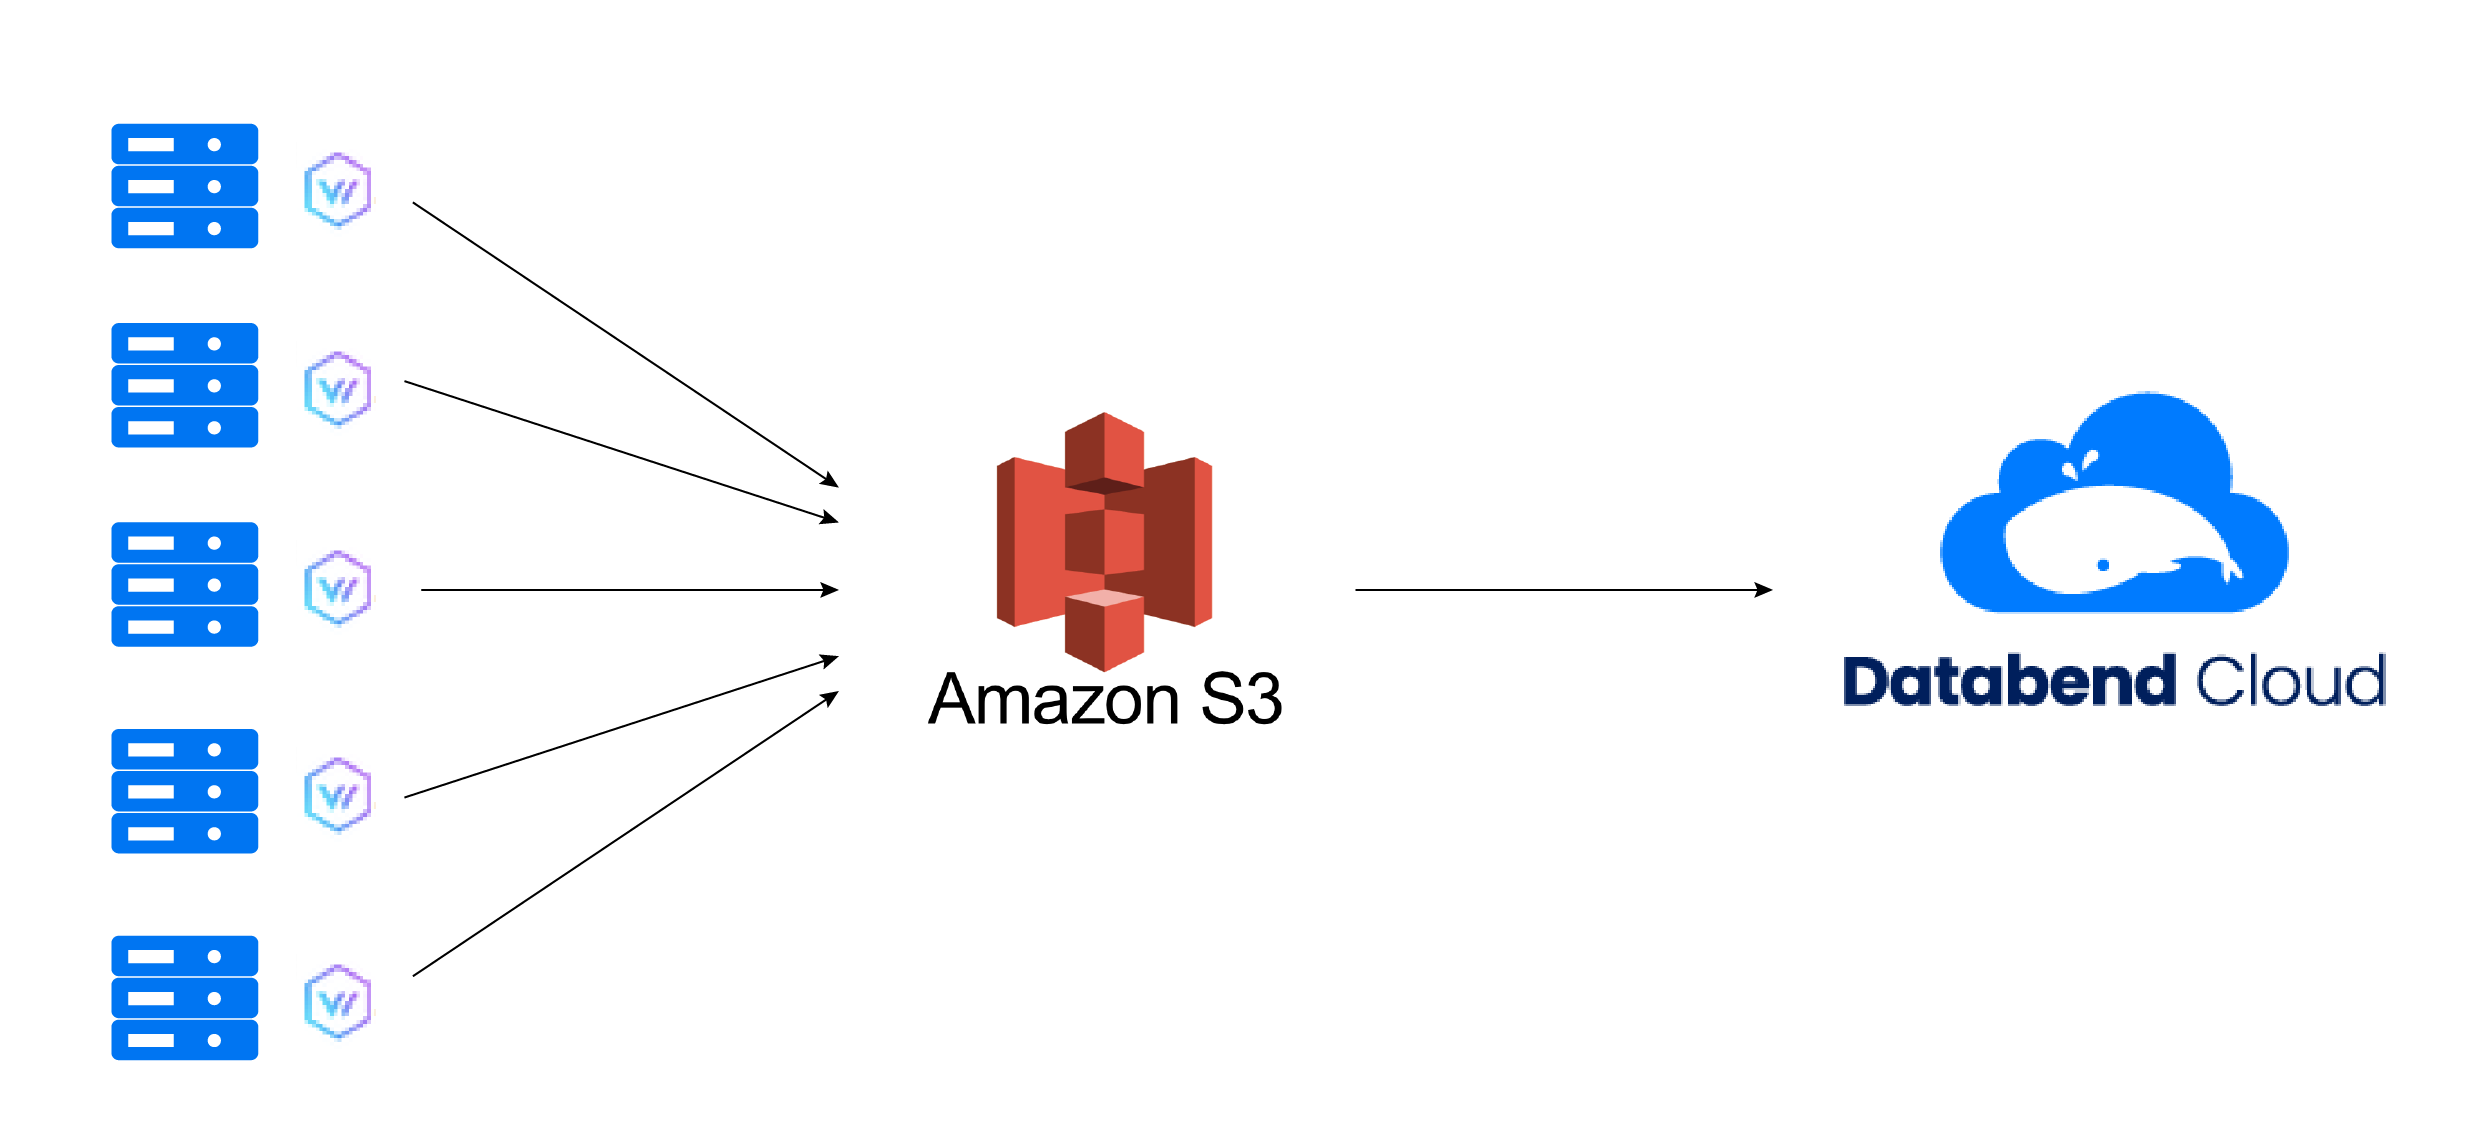
Vector 我用着挺顺手,麻烦一点的是解析规则。规则配好以后,同一类日志可以沿用。后面再加网关,也按这个方式采集。
S3 上的文件由 Databend 的加载任务消费。External Stage 连到采集目录,Task 定时加载,成功后就把对应的暂存文件清掉。日志已经进了表,不需要在中转目录再留一份;需要归档的原始日志另存。
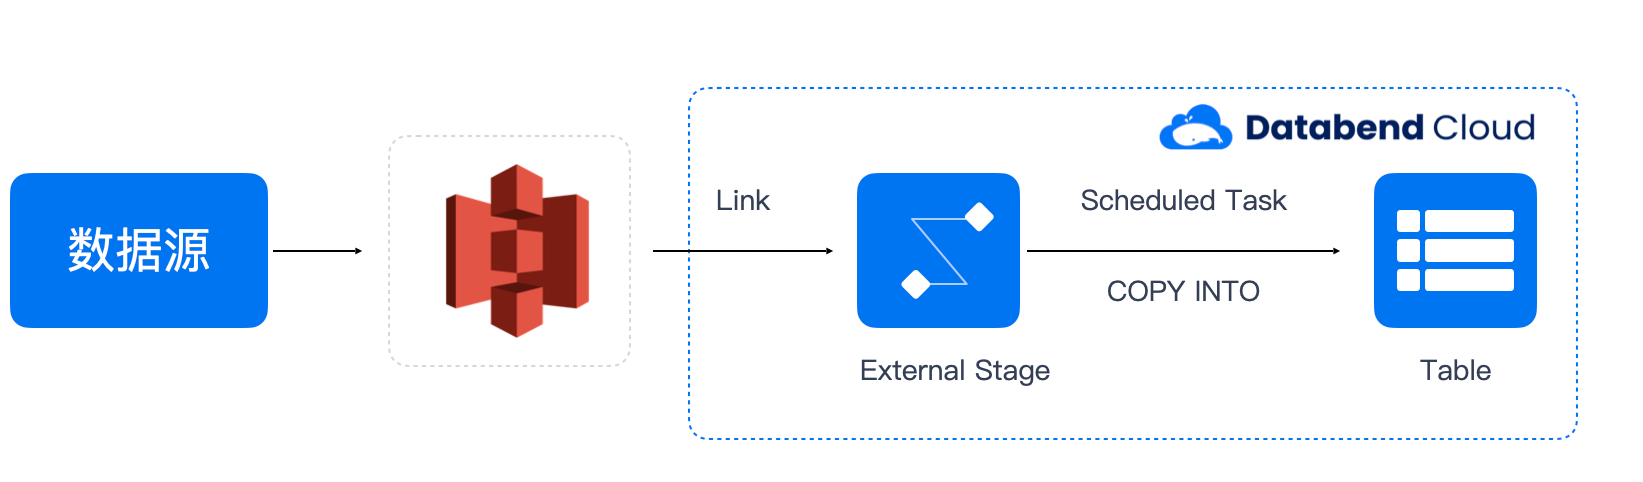
中间放 S3,是为了让采集和入库不用同时开着。Nginx 一直写日志,Vector 一直收,入库可以一分钟跑一次,也可以半小时跑一次。加载暂停了,文件先留在 S3,恢复后继续处理。
这样没有引入 Kafka,也不用另外维护一套数据加工集群。S3 在这里只做文件缓冲,没有消费组和分区顺序这类消息队列能力。
暂存目录和表数据目录要分开。暂存文件随加载清理,表数据按保留周期管理,不能给整个 Bucket 套一个统一的过期删除规则。
用 SQL 查日志
日志进了 Databend,就按数据库的习惯用。某段时间请求为什么变慢,哪些接口的 5xx 多,哪个 upstream 耗时高,写 SQL 就能查。业务分析人员也可以自己统计访问量、流量,或者把日志和业务表关联起来看。
固定报表接 Metabase、Superset。报警规则用 Task 定期计算,需要按新增数据处理时再接 Stream。通知可以用原生的 Notification Integration,这里不展开配置。
这几件事要和加载频率配合好。半小时才入库一次,就不能指望刚发生的错误马上触发报警。
过期日志定期删除,再按历史版本保留期回收空间。要拿走一段日志,按时间或其他查询条件导出到 S3 就行,不需要把整张表下载下来。
费用怎么算
我比较关心的是,日志到底需要多快查到。只是每天做统计,和线上排障时随时要查,计算资源的开法不一样。
加载和查询分开用 Warehouse。加载先用小规格,查询要多大,看常用 SQL 和并发情况。原分享按 0.075 元/分钟、每月 30 天算过一笔加载费用:
| 加载方式 | 假设计费时间 | 每月加载计算费 |
|---|---|---|
| 每 5 分钟加载一次 | 每次 1 分钟 | 648 元 |
| 每 30 分钟加载一次 | 每次 2 分钟 | 216 元 |
| 持续运行、按分钟调度 | 每天 1440 分钟 | 3240 元 |
业务能接受半小时的延迟,就有机会把这部分费用降下来。这里按 Warehouse 的实际计费时间算,SQL 执行完了,不代表已经停止计费。这是当时的估算单价,不是当前报价或 AWS 套餐价格,查询费用也没算在里面。
存储要看压缩后的存量。比如每天新增 1 TB 原始日志,保留 30 天,假设能压缩到十分之一:
| 项目 | 估算容量 |
|---|---|
| 30 天原始日志 | 30 TB |
| 压缩后的表数据 | 约 3 TB |
保留周期跑满以后,按这 3 TB 乘对应 Region 的存储单价,再加历史版本、暂存和归档。压缩比得拿自己的日志测,字段重复多的网关日志,和带大量随机内容的应用日志,结果会差不少。
还有流量费。应用、S3 和 Databend Cloud 尽量选同一云、同一 Region,先确认实际走哪条网络。每天几 TB 的日志,跨云、跨地域搬一遍,费用就不能忽略。S3 请求费、采集节点的 CPU 和磁盘也都要算上。
这套做法比较适合主要用 SQL 排查和统计日志、希望少维护几套系统的团队。要不要换,拿每天的日志量、保留天数、多久需要查到,以及几条常用查询,先算一遍就比较清楚了。已有日志平台里的报警和交互功能,也得一起评估,不能只比存储单价。
上述自动调度用的是 Databend Cloud 的 Task。自建开源版需要另外安排调度。
想聊自己的日志场景,可以微信联系我:82565387。
配套 Skill
我把这套方案的接入思路整理成了一个轻量 Skill,方便拿自己的日志场景来讨论。主要回答三个问题:已有 Vector 怎么接、不同日志来源怎么分表、入库和查询分别由哪些资源处理。
解压后放到你使用的 Agent 的 Skill 目录,或者直接让它读取 SKILL.md。比如这样问:
我已经有 Vector,想把不同来源的日志接到 Databend,分别存表。采集、入库和查询应该怎么安排?
这个 Skill 只讲方案,不带部署脚本,也不需要提供环境权限或凭据。